iOSアプリの個人開発での自分とAIの役割分担のプラクティス
今回は、iOSアプリ「Meemie」の個人開発で、自分とAIエージェントがそれぞれ何をしていたのかを、図にして整理した備忘録です。アプリを公開するまでの経緯については以下の記事で紹介しています。


役割の分け方は最初から決まっていたわけではなく、進めながら試行錯誤して変えています。2026年9月前後のプラクティスなので、登場する手法もツールも陳腐化している可能性がある点に留意した上で参考程度に読んでください。
この記事のターゲット
AIにコードを書いてもらう開発で、自分が何をすればよいのか分からない方
複数のAIエージェントを使い分けてみたい方
コードを書かない立場で開発に関わるデザイナー
役割分担はやりながら変える
Meemieの開発では、私はコードを書いていません。代わりに何をしていたのかは一旦棚に上げて、まずはAI側の体制から書いていきます。
体制は大きく3つの時期に分かれます。公開の準備を一気に進めた7月、公開後の改良に入った8月、そして直近の9月です。リポジトリの記録を数えてもらったところ、コミットの数は7月が272件、8月が32件、9月が47件でした。7月だけ桁が違うのは、計画を立ててから審査に提出するまでを1か月で詰め込んだためです。
ちなみに、現在は
それぞれの時期の構成を並べると以下の通りです。
構成A(7月) | 構成B(8月) | 構成C(9月〜現在) | |
|---|---|---|---|
進行役 | 人がセッションを1つずつ起こす。計画はClaude Fable 5 | Claudeのメインセッションが統括する | Claude Opus 5.5が統括する |
実装 | Claude Sonnet 5とClaude Opus 4.8 | Codex(8月時点ではGPT-5.6 Luna)。一部はClaude Sonnet 5.5 | 構成Bと同じ+難易度の高い実装はGPT-5.6 Solに委託 |
レビュー | 実装と同じセッションの中のレビュー役(Opus 4.8) | 実装役とは別のエージェント | 構成Bと同じ |
調査 | 読むだけの調査役(Claude Haiku 4.5) | 構成Aと同じ | 構成Aと同じ |
相談 | なし | なし | 詰まったらClaude Fable 5.1に相談する |
構成A(7月):1つのセッションが実装もレビューもしていた
7月5日に、公開に向けた計画を立てました。このときClaude Fable 5のセッションにコード全体を点検してもらい、見つかった72件の指摘をもとに、やるべき作業の一覧を作っています。
この一覧には、作業ごとに「どのモデルに任せるか」まで書いてあります。仕様が固まっていて書くだけの作業はSonnet 5、設計の判断が残っている作業とレビューはOpus 4.8、コードを読んで調べるだけの役はHaiku 4.5、という割り当てです。迷ったときの基準も一覧に書いてあって、触るファイルが3つ以上になるか、ほかから呼ばれる部分が変わるならOpus、それ以外はSonnetとしていました。
進め方の決まりは3つだけです。
1回のセッションで扱う作業は原則1つ
テストを先に書く
終わりの関門は、検証のスクリプト、レビュー役による確認、コミットの順に通す
図にすると以下の通りです。
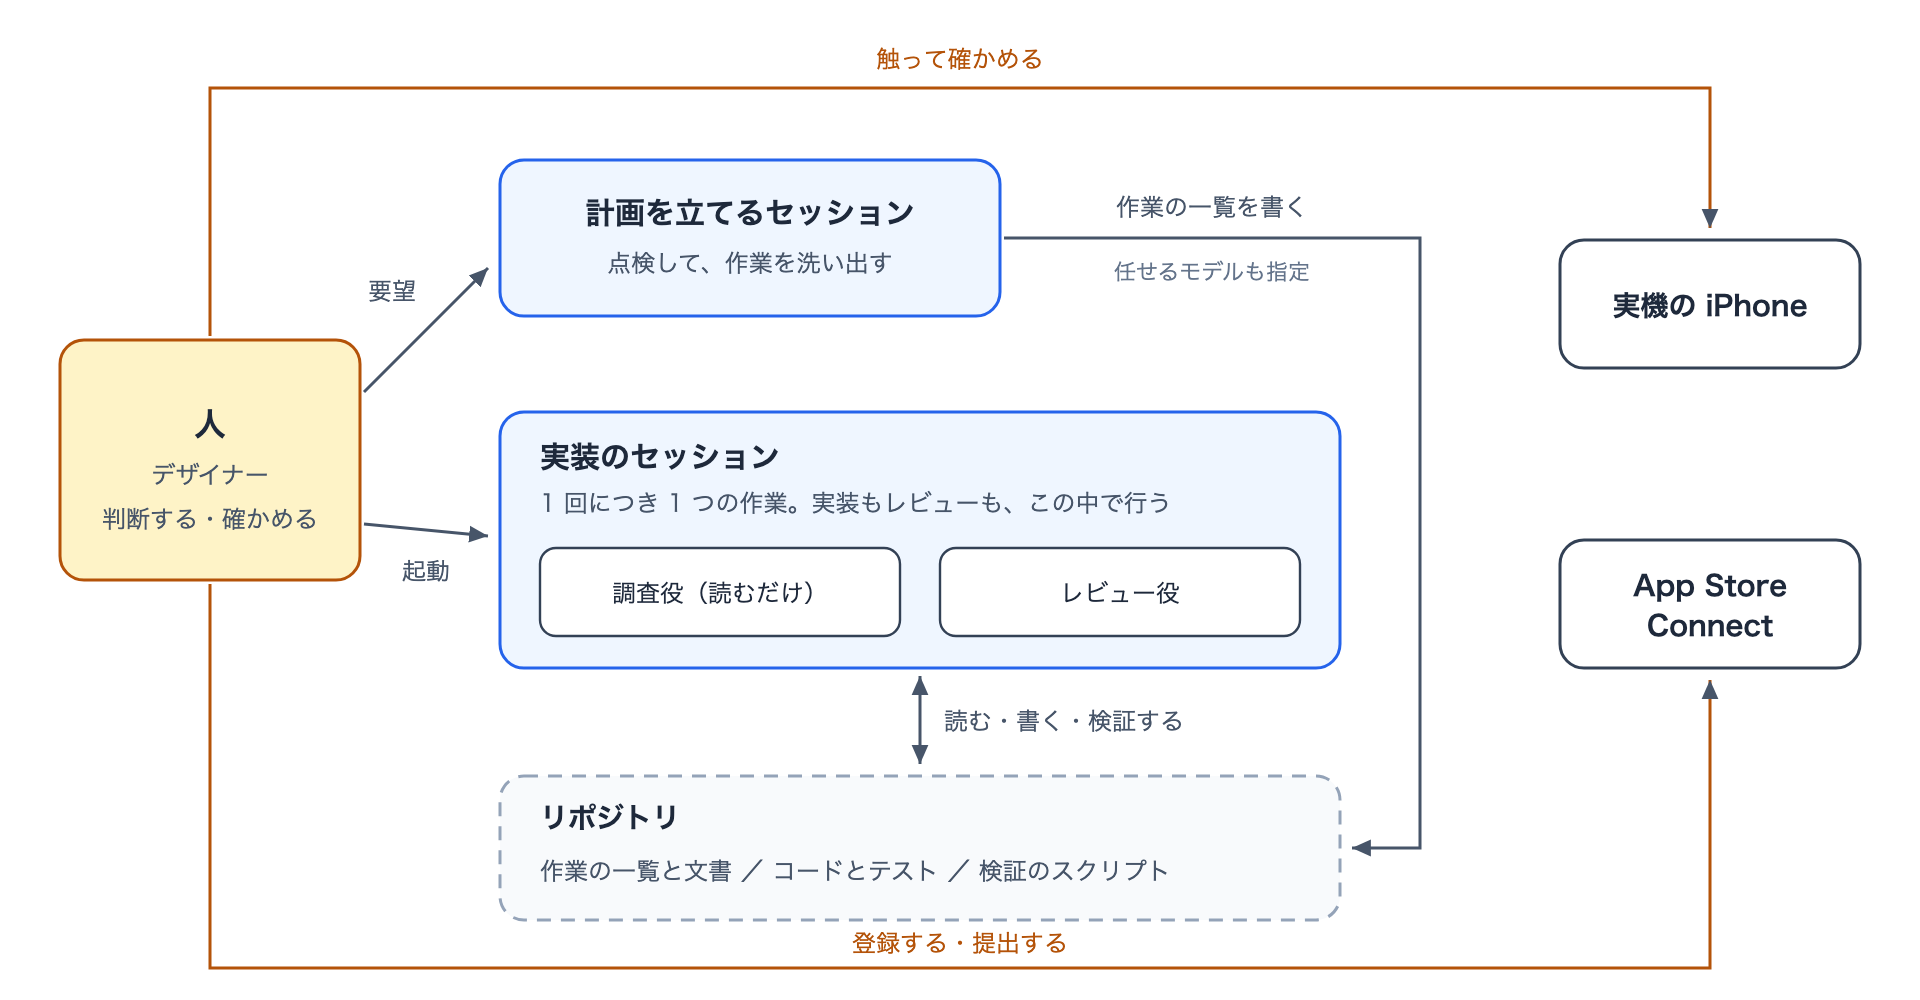
私の操作は、一覧から作業を選んで、起動用のプロンプトを貼ってセッションを開始するだけです。開始されたセッションは一覧と文書を読み、実装・検証して、同じセッションの中にいるレビュー役に見てもらってからコミットします。
この構成でうまくいかなかったことはいくつかありますが、代表的なものを紹介します。
1つ目は、セッション同士が競合しやすいことです。人が手でセッションを起こすので、2つ同時に動かしたい瞬間があったりします。実際に、同時に編集したせいで、別のセッションのコミットに関係のない変更が混ざる競合が頻発しました。それ以降、起動用のプロンプトの先頭に「作業中の変更が残っていたら、何もせずに私へ確認する」という手順を入れました。
2つ目は、利用の上限です。割り当てを決めておいても、上限に当たると予定のモデルが使えません。サブエージェントとして委託していたCodexの上限に達したのでFableが直接実装した、というようなことが起きます。この場合、想定していたよりもFableやClaudeのトークン消費が早く消費してしまい、共倒れになってリセットを待ちぼうけする、という事態が何度かありました。
構成BとC(8月以降):統括と実装とレビューを分けた
公開後は、役割を3つに分けました。統括するAI、実装するAI、レビューするAIです。
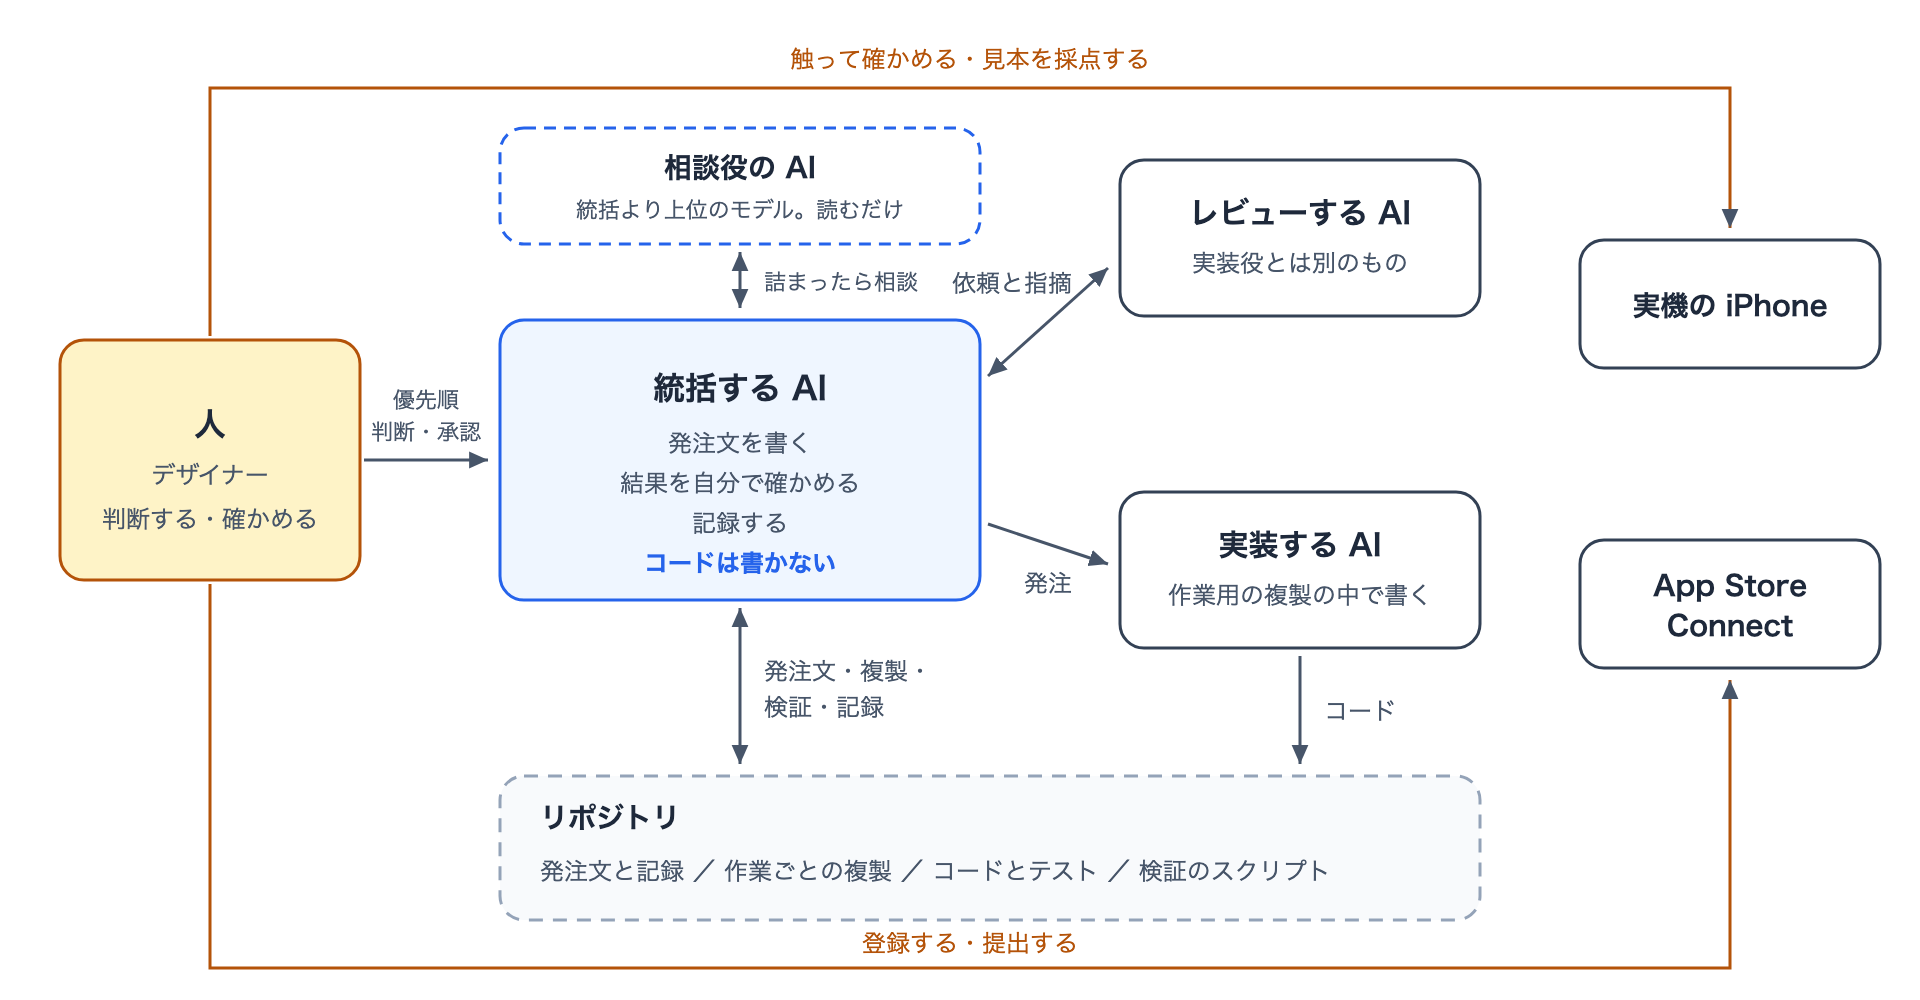
統括するAIには、コードを書かせずに、サブエージェントへの発注文を書く、作業用の複製を用意する、結果を自分で確かめる、取り込んで記録する、などの4つの指令を担当させます。
実装は別のAIに発注します。Meemieの場合はCodexでした。8月時点では不確実性の低い実装はGPT-5.6 Lunaに原則として委託するようハーネスで定義していました。ローカルで動かしているモデルもありましたが、iOSのコードは環境的な制約でビルドできなかったので、Meemieの実装には使っていません。
レビューは、実装役とは別のエージェントが行います。
この構成で分かったことは2つあります。
1つは、実装役の報告をそのまま信じてはいけない、ということです。Codexの作業環境では画像処理が正しく動かず、画像を扱うテストが、実装とは関係のない理由で失敗します。そのため、テストの最終的な合否は、統括するAIが自分の環境で検証をやり直して決めることにしました。発注文の受入条件には、1つずつ「実装役が確かめる」「統括が確かめる」と書いています。
もう1つは、往復が止まらないことがある、ということです。規則どおりに役割を分けて進めたのに、レビューと修正の往復が6周続き、止まるまでに11時間以上かかった作業がありました。役割を分けるだけでは足りず、止め方も決めておく必要があります。
構成Cは、構成Bとほとんど同じで、主な差分は統括がClaude Opus 5.5になったことと、詰まったときの相談先としてClaude Fable 5.1を置いたことです。相談役は、読むだけの別のエージェントとして必要なときにだけ呼びます。相談先として使いはじめたのは9月の終わりごろです。
相談役を常に付けておく方法もあります。ただ、相談のたびにそれまでの会話をすべて読み直すことになるので、トークン量の節約的にも、詰まったときだけにしています。
1つの作業が終わるまで
構成BとCで、1つの作業がどう流れるのかを図にしました。実際の発注1件の記録をトレースしています。
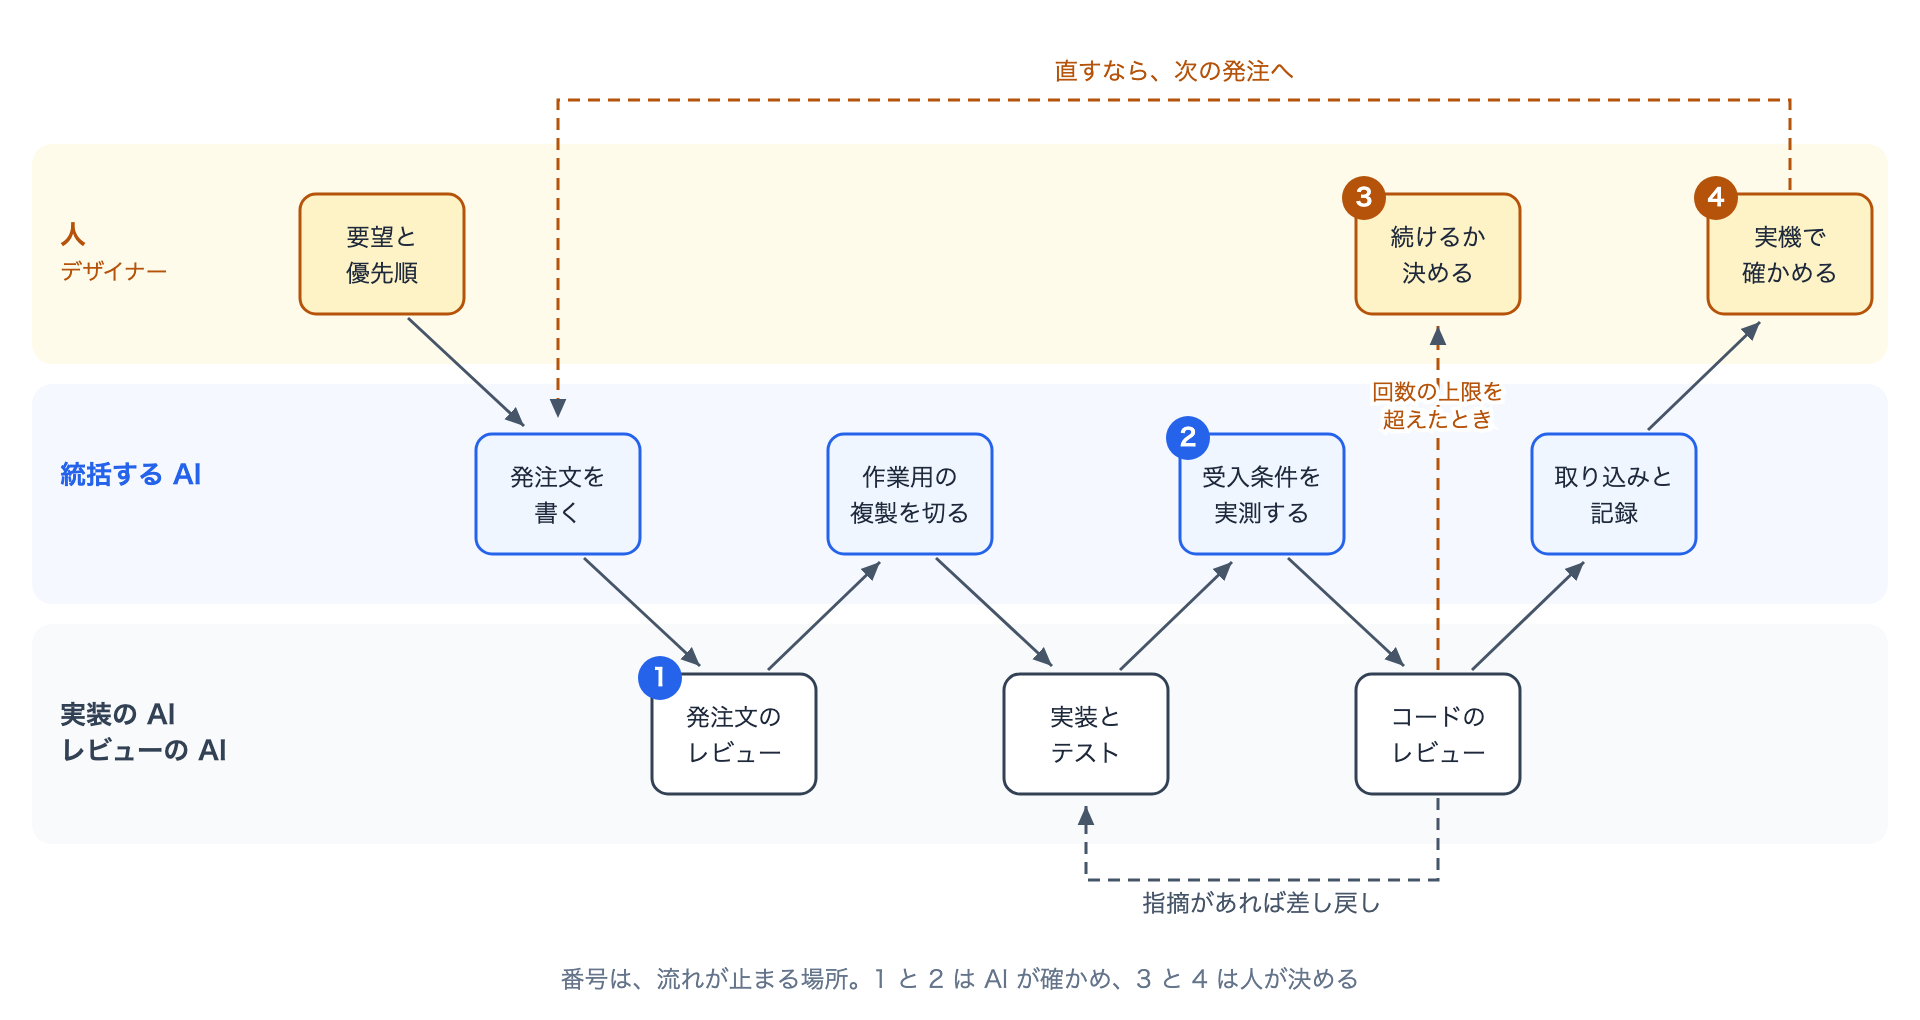
順番に書くと以下の通りです。
人が、何を先にやるかを決める
統括するAIが発注文を作成。項目は、目的、成果物、仕様、外から観測できる性質、変更前の状態、「〜は起きない」という前提の一覧、受入条件、止める条件、やらないこと
その発注文を、別のAIがレビューする。わずかな変更であれば省略
統括するAIが、作業用の複製を用意する。ほかの作業と並行して進めるので、本体の作業場所は使用しない
実装するAIが、複製の中で実装とテストをする
統括するAIが、自分に割り当てられた受入条件を自分の環境で確かめる
レビューするAIがコードを確認し、指摘があれば5へ差し戻す
戻る回数が決めておいた上限を超えたら、続けるかどうかを人が決める
統括するAIが取り込んで、記録する
人が実機で確かめる。直すところがあれば、次の発注に回す
流れが止まる場所は、3、6、8、10の4つです。3と6はAIが確かめ、8と10は人が決めます。
8は実際に起きています。図のもとにした発注では、3周目に入る前に統括するAIが止まり、決めておいた上限を超えることと、残っている指摘の内容を報告してきました。それに対して私が「推奨で進めて」と返して、続きが動いています。
チェックポイントを先に決めておくと、人は常に監視しなくて済みます。逆に、決めていなかった頃は、気づいたときには後続の発注がモグラ叩きの如く何周もループしている、ということがありました。
人がやっていたこと
最後に、コードを書かなかった私が何をしていたのかを、記録に残っている実例と一緒に並べておきます。
決める
価格、配信する地域、公開の方式は、どれも記録に「ユーザーの判断」と書いてあります。AIは市場の調査や選択肢の整理まではやってくれますが、決めるのは人でした。公開後の改良で何を先にやるかも同じです。
実物を触る
実機でしか確かめられないことがあります。たとえば、端末が熱くなるなどの物理的に影響するパフォーマンスの問題や、アプリ内課金の購入が通るかどうかも、テスト配信した実機で確かめています。
AIが入れない場所を操作する
App Storeの管理画面は、AIのセッションからは操作できません。AIがクリックする順番と入力する値を書き出し、私がそのとおりに操作しました。提出に必要だった項目の多くは、この形で進めています。
AIが自分では書き換えられないものを直す
AIの設定ファイルに誤りが見つかったとき、AIは自分のセッションからその設定を書き換えられませんでした。直す箇所を3つ書き出してもらい、人の側で直すことになりました。この話は、ハーネスの変遷の回で詳しく書きます。
続けるかどうかを決める
前の節の8番です。
こうして並べてみると、自分で手を動かす量はかなり少なくなり、自律的に作業を進行できる期間も長くなりましたが、決めることと受入確認は、まだ人のタスクとして残っています。
決めることも基本的には複数のオプションの中からなぜその選択をするのが必然かを説明できる形で提案してもらい、それを私が承認する形なので、決めることも実質はAIが行っています。
最終的には、iPhone Duoの対応など、創造的で無いが必要な類の作業はどんどん自動化していきたいと思っています。